MySQL基础篇
DDL(数据定义语言)
作用:
用来定义数据库对象(数据库、表、字段)
数据库操作
① 查询所有数据库
1 | SHOW DATABASES; |
② 查询当前数据库:
1 | SELECT DATABASE(); |
③ 创建数据库:
1 | CREATE DATABASE [ IF NOT EXISTS ] 数据库名 [ DEFAULT CHARSET 字符集] [COLLATE 排序规则 ]; |
④ 删除数据库:
1 | DROP DATABASE [ IF EXISTS ] 数据库名; |
⑤ 使用数据库:
1 | USE 数据库名; |
注意:UTF8字符集长度为3字节,有些符号占4字节,所以推荐用utf8mb4字符集
表操作
(1) 查询当前数据库所有表:
1 | SHOW TABLES; |
(2) 查询表结构:
1 | DESC 表名; |
(3) 查询指定表的建表语句:
1 | SHOW CREATE TABLE 表名; |
(4) 创建表:
1 | CREATE TABLE 表名( |
注意:最后一个字段后面没有逗号
(5) 添加字段:
1 | ALTER TABLE 表名 ADD 字段名 类型(长度) [COMMENT 注释] [约束]; |
例:ALTER TABLE emp ADD nickname varchar(20) COMMENT '昵称';
(6) 修改数据类型:
1 | ALTER TABLE 表名 MODIFY 字段名 新数据类型(长度); |
(7) 修改字段名和字段类型:
1 | ALTER TABLE 表名 CHANGE 旧字段名 新字段名 类型(长度) [COMMENT 注释] [约束]; |
例:将emp表的nickname字段修改为username,类型为varchar(30)
ALTER TABLE emp CHANGE nickname username varchar(30) COMMENT '昵称';
(8) 删除字段:
1 | ALTER TABLE 表名 DROP 字段名; |
(9) 修改表名:
1 | ALTER TABLE 表名 RENAME TO 新表名 |
(10) 删除表:
1 | DROP TABLE [IF EXISTS] 表名; |
数据类型
用于存储数字,分整数、浮点、定点数:
整数类型(按范围从小到大)
| 类型 | 大小 | 有符号范围 | 无符号范围 | 说明 |
|---|---|---|---|---|
| TINYINT | 1byte | (-128, 127) | (0, 255) | 小整数 |
| SMALLINT | 2bytes | (-32768, 32767) | (0, 65535) | 中整数 |
| MEDIUMINT | 3bytes | (-8388608, 8388607) | (0, 16777215) | 大整数 |
| INT/INTEGER | 4bytes | (-2147483648, 2147483647) | (0, 4294967295) | 常用大整数 |
| BIGINT | 8bytes | (-2^63, 2^63-1) | (0, 2^64-1) | 极大整数 |
✅ 备注:无符号整数写法(如无符号 int):INT UNSIGNED
浮点 / 定点数
| 类型 | 大小 | 说明 |
|---|---|---|
| FLOAT | 4bytes | 单精度浮点(范围约 ±3.4E+38) |
| DOUBLE | 8bytes | 双精度浮点(范围约 ±1.8E+308) |
| DECIMAL | 依赖 M/D | 精确定点数(适合金额等场景) |
✅ 备注:double 可指定 “总长 + 小数位”,格式:double(总长, 小数位)(如double(4,1))
字符类型
用于存储字符串 / 二进制数据,分定长、变长、二进制、文本:
| 类型 | 大小范围 | 描述 |
|---|---|---|
| CHAR | 0-255bytes | 定长字符串(性能高) |
| VARCHAR | 0-65535bytes | 变长字符串(性能略低) |
| TINYBLOB | 0-255bytes | 小二进制数据(≤255 字符) |
| TINYTEXT | 0-255bytes | 短文本字符串 |
| BLOB | 0-65535bytes | 长二进制数据 |
| TEXT | 0-65535bytes | 长文本数据 |
| MEDIUMBLOB | 0-16777215bytes | 中等长二进制数据 |
| MEDIUMTEXT | 0-16777215bytes | 中等长文本数据 |
| LONGBLOB | 0-4294967295bytes | 极大二进制数据 |
| LONGTEXT | 0-4294967295bytes | 极大文本数据 |
✅ 性能提示:同长度下,char(n)(如char(10))性能优于varchar(n)(定长存储更高效)
日期时间类型
用于存储日期、时间相关数据:
| 类型 | 大小 | 范围 | 格式 | 描述 |
|---|---|---|---|---|
| DATE | 3bytes | 1000-01-01 ~ 9999-12-31 | YYYY-MM-DD | 纯日期值 |
| TIME | 3bytes | -838:59:59 ~ 838:59:59 | HH:MM:SS | 时间间隔 / 持续时间 |
| YEAR | 1byte | 1901 ~ 2155 | YYYY | 纯年份值 |
| DATETIME | 8bytes | 1000-01-01 00:00:00 ~ 9999-12-31 23:59:59 | YYYY-MM-DD HH:MM:SS | 混合日期 + 时间 |
| TIMESTAMP | 4bytes | 1970-01-01 00:00:01 ~ 2038-01-19 03:14:07 | YYYY-MM-DD HH:MM:SS | 带时间戳特性的日期时间 |
DML(数据操作语言)
添加数据
(1) 指定字段:
1 | INSERT INTO 表名 (字段名1, 字段名2, ...) VALUES (值1, 值2, ...); |
(2) 全部字段:
1 | INSERT INTO 表名 VALUES (值1, 值2, ...); |
(3) 批量添加数据:
1 | INSERT INTO 表名 (字段名1, 字段名2, ...) VALUES (值1, 值2, ...), (值1, 值2, ...), (值1, 值2, ...); |
注意:
- 字符串和日期类型数据应该包含在引号中
- 插入的数据大小应该在字段的规定范围内
更新和删除数据
(1) 修改数据:
1 | UPDATE 表名 SET 字段名1 = 值1, 字段名2 = 值2, ... [ WHERE 条件 ]; |
(2) 删除数据:
1 | DELETE FROM 表名 [ WHERE 条件 ]; |
DQL(数据查询语言)
语法:
1 | SELECT |
基础查询
(1) 查询多个字段:
1 | SELECT 字段1, 字段2, 字段3, ... FROM 表名; |
(2) 设置别名:
1 | SELECT 字段1 [ AS 别名1 ], 字段2 [ AS 别名2 ], 字段3 [ AS 别名3 ], ... FROM 表名; |
(3) 去除重复记录:
1 | SELECT DISTINCT 字段列表 FROM 表名; |
条件查询
(1) 语法:
1 | SELECT 字段列表 FROM 表名 WHERE 条件列表; |
(2) 条件:
| 比较运算符 | 功能 |
|---|---|
| > | 大于 |
| >= | 大于等于 |
| < | 小于 |
| <= | 小于等于 |
| = | 等于 |
| <> 或 != | 不等于 |
| BETWEEN … AND … | 在某个范围内(含最小、最大值) |
| IN(…) | 在in之后的列表中的值,多选一 |
| LIKE 占位符 | 模糊匹配(_匹配单个字符,%匹配任意个字符) |
| IS NULL | 是NULL |
| 逻辑运算符 | 功能 |
|---|---|
| AND 或 && | 并且(多个条件同时成立) |
| OR 或 || | 或者(多个条件任意一个成立) |
| NOT 或 ! | 非,不是 |
(3) 例子:
1 | -- 1. 查询年龄等于 88 的员工 |
注意:MySQL 中查询 idCard 为 NULL 的员工时,不能用 idCard = null 或 idCard == null,在 MySQL 中,NULL表示「未知值」,不是一个具体的数值 / 字符串,因此普通的比较运算符(=、==、!=、<>)无法和 NULL 进行有效比较—— 用这些运算符和 NULL 比较的结果既不是TRUE也不是FALSE,而是NULL(不成立),最终查不到任何数据。
聚合查询(聚合函数)
(1) 常见聚合函数:
| 函数 | 功能 |
|---|---|
| count | 统计数量 |
| max | 最大值 |
| min | 最小值 |
| avg | 平均值 |
| sum | 求和 |
(2) 语法:
1 | SELECT 聚合函数(字段列表) FROM 表名; |
(3) 代码示例:
1 | -- 1.统计该企业员工数量 |
注意:null 值不参与所有聚合函数运算
关键逻辑:count(\*)
统计所有符合条件的行数(不管字段是否为 NULL),只要这一行存在,就会被计数,适合直接统计 “员工总数”。
分组查询
(1) 语法:
1 | SELECT 字段列表 FROM 表名 [ WHERE 条件 ] GROUP BY 分组字段名 [ HAVING 分组后的过滤条件 ]; |
(2) where 和 having 的区别:
- 执行时机不同:where是分组之前进行过滤,不满足where条件不参与分组;having是分组后对结果进行过滤。
- 判断条件不同:where不能对聚合函数进行判断,而having可以。
(3) 代码示例:
1 | -- 1.根据性别分组,统计男性员工和女性员工的数量 |
关键逻辑:
① HAVING COUNT(*) >= 3
分组后的筛选:只保留 “统计人数 ≥ 3” 的分组 —— 比如西安分组只有 2 人,就会被筛掉;北京有 6 人、上海 4 人、江苏 3 人,都会保留。
→ 记住:HAVING只管 “分组后的统计结果”(比如 COUNT (*)),不管 “单个员工的字段”。
② SELECT workaddress,count(*)
最终展示:把筛选后的分组结果展示出来,列是 “工作地址” 和 “对应人数”。
(4) 注意事项
- 执行顺序:where > 聚合函数 > having,因为
WHERE先筛行→GROUP BY分组→聚合函数统计→HAVING筛组 - 分组之后,查询的字段一般为聚合函数和分组字段,查询其他字段无任何意义(上述例子中,workaddress 是 分组标识,count(*) 是聚合函数)
排序查询
(1) 语法:
1 | SELECT 字段列表 FROM 表名 ORDER BY 字段1 排序方式1, 字段2 排序方式2; |
(2) 排序方式:
- ASC: 升序(默认)
- DESC: 降序
(3) 代码示例:
1 | -- 1.根据年龄对公司的员工进行升序排序 |
(4) 注意:如果是多字段排序,当第一个字段值相同时,才会根据第二个字段进行排序
分页查询
(1) 语法:
1 | SELECT 字段列表 FROM 表名 LIMIT 起始索引, 查询记录数; |
(2) 注意:
- 起始索引从0开始,起始索引 = (查询页码 - 1) * 每页显示记录数
- 分页查询是数据库的方言,不同数据库有不同实现,MySQL是LIMIT
- 如果查询的是第一页数据,起始索引可以省略,直接简写 LIMIT 10
(3) 代码示例:
1 | -- 1.查询第1页员工数据,每页展示10条记录 |
综合练习
1 | -- 1.查询年龄为20,21,22,23岁的女性员工信息 |
DQL 编写顺序
1 | 1. FROM → 2. WHERE → 3. GROUP BY → 4. HAVING → 5. ORDER BY → 6. LIMIT |
DQL执行顺序
FROM -> WHERE -> GROUP BY、HAVING -> SELECT -> ORDER BY -> LIMIT
DCL
管理用户
(1) 查询用户:
1 | USE mysql; |
(2) 创建用户:
1 | CREATE USER '用户名'@'主机名' IDENTIFIED BY '密码'; |
(3) 修改用户密码:
1 | ALTER USER '用户名'@'主机名' IDENTIFIED WITH mysql_native_password BY '新密码'; |
(4) 删除用户:
1 | DROP USER '用户名'@'主机名'; |
(5) 代码示例:
1 | -- 创建用户test,只能在当前主机localhost访问 |
权限控制
(1) 常用权限:
| 权限 | 说明 |
|---|---|
| ALL, ALL PRIVILEGES | 所有权限 |
| SELECT | 查询数据 |
| INSERT | 插入数据 |
| UPDATE | 修改数据 |
| DELETE | 删除数据 |
| ALTER | 修改表 |
| DROP | 删除数据库/表/视图 |
| CREATE | 创建数据库/表 |
(2) 查询权限:
1 | SHOW GRANTS FOR '用户名'@'主机名'; |
(3) 授予权限:
1 | GRANT 权限列表 ON 数据库名.表名 TO '用户名'@'主机名'; |
(4) 撤销权限:
1 | REVOKE 权限列表 ON 数据库名.表名 FROM '用户名'@'主机名'; |
(5) 注意事项
- 多个权限用逗号分隔
- 授权时,数据库名和表名可以用 * 进行通配,代表所有
实用技巧
DataGrip 快速执行单行 SQL 的方法
使用 Ctrl+Enter(Windows/Linux),无需选中整行,只需将光标定位在目标行,按下此快捷键,DataGrip 会自动执行该行完整 SQL 语句。
换行技巧(无需移到行尾)
Windows/Linux:Shift + Enter
单行注释(最常用)
用 --(两个减号)开头,后面跟注释内容,注释范围从--到行尾。
1 | -- 这是单行注释(整行注释) |
函数
- 字符串函数
- 数值函数
- 日期函数
- 流程函数
字符串函数
(1) 常用函数:
| 函数 | 功能 |
|---|---|
| CONCAT(s1, s2, …, sn) | 字符串拼接,将s1, s2, …, sn拼接成一个字符串 |
| LOWER(str) | 将字符串全部转为小写 |
| UPPER(str) | 将字符串全部转为大写 |
| LPAD(str, n, pad) | 左填充,用字符串pad对str的左边进行填充,达到n个字符串长度 |
| RPAD(str, n, pad) | 右填充,用字符串pad对str的右边进行填充,达到n个字符串长度 |
| TRIM(str) | 去掉字符串头部和尾部的空格 |
| SUBSTRING(str, start, len) | 返回从字符串str从start位置起的len个长度的字符串 |
| REPLACE(column, source, replace) | 替换字符串 |
(2) 使用示例:
1 | select concat('Hello','MySQL'); |
数值函数
(1) 常见函数:
| 函数 | 功能 |
|---|---|
| CEIL(x) | 向上取整 |
| FLOOR(x) | 向下取整 |
| MOD(x, y) | 返回x/y的模 |
| RAND() | 返回0~1内的随机数 |
| ROUND(x, y) | 求参数x的四舍五入值,保留y位小数 |
(2) 代码示例:
1 | select ceil(1.5); |
日期函数
(1) 常用函数:
| 函数 | 功能 |
|---|---|
| CURDATE() | 返回当前日期 |
| CURTIME() | 返回当前时间 |
| NOW() | 返回当前日期和时间 |
| YEAR(date) | 获取指定date的年份 |
| MONTH(date) | 获取指定date的月份 |
| DAY(date) | 获取指定date的日期 |
| DATE_ADD(date, INTERVAL expr type) | 返回一个日期/时间值加上一个时间间隔expr后的时间值 |
| DATEDIFF(date1, date2) | 返回起始时间date1和结束时间date2之间的天数 |
(2) 代码示例:
1 | select curdate(); |
流程函数
(1) 常用函数:
| 函数 | 功能 |
|---|---|
| IF(value, t, f) | 如果value为true,则返回t,否则返回f |
| IFNULL(value1, value2) | 如果value1不为空,返回value1,否则返回value2 |
| CASE WHEN [ val1 ] THEN [ res1 ] … ELSE [ default ] END | 如果val1为true,返回res1,… 否则返回default默认值 |
| CASE [ expr ] WHEN [ val1 ] THEN [ res1 ] … ELSE [ default ] END | 如果expr的值等于val1,返回res1,… 否则返回default默认值 |
(2) 代码示例:
1 | select if(true,'OK','Error'); |
1 | select |
约束
分类:
| 约束 | 描述 | 关键字 |
|---|---|---|
| 非空约束 | 限制该字段的数据不能为null | NOT NULL |
| 唯一约束 | 保证该字段的所有数据都是唯一、不重复的 | UNIQUE |
| 主键约束 | 主键是一行数据的唯一标识,要求非空且唯一 | PRIMARY KEY |
| 默认约束 | 保存数据时,如果未指定该字段的值,则采用默认值 | DEFAULT |
| 检查约束(8.0.1版本后) | 保证字段值满足某一个条件 | CHECK |
| 外键约束 | 用来让两张图的数据之间建立连接,保证数据的一致性和完整性 | FOREIGN KEY |
约束是作用于表中字段上的,可以再创建表/修改表的时候添加约束。
常用约束
| 约束条件 | 关键字 |
|---|---|
| 主键 | PRIMARY KEY |
| 自动增长 | AUTO_INCREMENT |
| 不为空 | NOT NULL |
| 唯一 | UNIQUE |
| 逻辑条件 | CHECK |
| 默认值 | DEFAULT |
代码示例:
1 | create table user( |
外键约束
(1) 添加外键
方法一:
1 | CREATE TABLE 表名( |
方法二:
1 | ALTER TABLE 表名 ADD CONSTRAINT 外键名称 FOREIGN KEY (外键字段名) REFERENCES 主表(主表列名); |
(2) 删除外键:
1 | ALTER TABLE 表名 DROP FOREIGN KEY 外键名; |
(2) 删除/更新行为
| 行为 | 说明 |
|---|---|
| NO ACTION | 当在父表中删除/更新对应记录时,首先检查该记录是否有对应外键,如果有则不允许删除/更新(与RESTRICT一致) |
| RESTRICT | 当在父表中删除/更新对应记录时,首先检查该记录是否有对应外键,如果有则不允许删除/更新(与NO ACTION一致) |
| CASCADE | 当在父表中删除/更新对应记录时,首先检查该记录是否有对应外键,如果有则也删除/更新外键在子表中的记录 |
| SET NULL | 当在父表中删除/更新对应记录时,首先检查该记录是否有对应外键,如果有则设置子表中该外键值为null(要求该外键允许为null) |
| SET DEFAULT(不重要) | 父表有变更时,子表将外键设为一个默认值(Innodb不支持) |
(3) 更改删除/更新行为:
1 | ALTER TABLE 表名 ADD CONSTRAINT 外键名称 FOREIGN KEY (外键字段) REFERENCES 主表名(主表字段名) ON UPDATE 行为 ON DELETE 行为; |
多表查询
多表关系
- 一对多(多对一)
- 多对多
- 一对一
(1) 一对多
案例:部门与员工
关系:一个部门对应多个员工,一个员工对应一个部门
实现:在多的一方建立外键,指向一的一方的主键
(2) 多对多
案例:学生与课程
关系:一个学生可以选多门课程,一门课程也可以供多个学生选修
实现:建立第三张中间表,中间表至少包含两个外键,分别关联两方主键
(3) 一对一
案例:用户与用户详情
关系:一对一关系,多用于单表拆分,将一张表的基础字段放在一张表中,其他详情字段放在另一张表中,以提升操作效率
实现:在任意一方加入外键,关联另外一方的主键,并且设置外键为唯一的(UNIQUE)
查询
(1) 合并查询(笛卡尔积,会展示所有组合结果):
1 | select * from employee, dept; |
- 笛卡尔积:两个集合A集合和B集合的所有组合情况(在多表查询时,需要消除无效的笛卡尔积)
(2) 消除无效笛卡尔积:
1 | select * from emp, dept where dept_id = dept.id; |
(3) 内连接查询
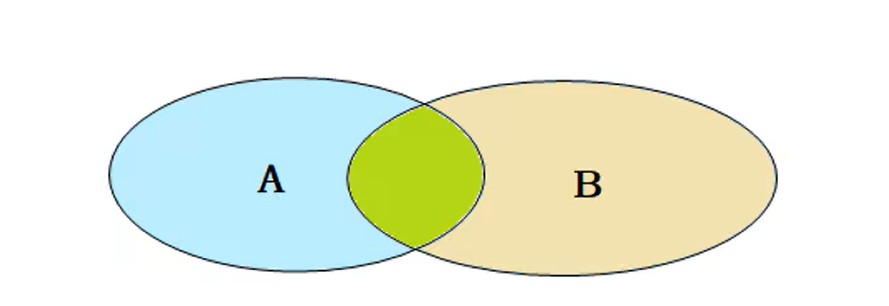
① 内连接查询的是两张表交集的部分,即如图的绿色部分
② 隐式内连接:
1 | SELECT 字段列表 FROM 表1, 表2 WHERE 条件 ...; |
③ 显式内连接:
1 | SELECT 字段列表 FROM 表1 [ INNER ] JOIN 表2 ON 连接条件 ...; |
④ 代码示例:
1 | -- 隐式内连接 |
(4) 外连接查询
① 左外连接:查询左表所有数据,以及两张表交集部分数据(相当于蓝色部分 + 绿色部分),相当于查询表1的所有数据,包含表1和表2交集部分数据
1 | SELECT 字段列表 FROM 表1 LEFT [ OUTER ] JOIN 表2 ON 条件 ...; |
② 右外连接:查询右表所有数据,以及两张表交集部分数据,相当于查询表 2 的所有数据,同时包含表 1 与表 2 交集部分数据
1 | SELECT 字段列表 FROM 表1 RIGHT [ OUTER ] JOIN 表2 ON 条件 ...; |
③ 代码示例:
1 | -- 左 |
关键逻辑:
1 | select d.name, e.* from dept d left outer join emp e on e.dept = d.id; |
- 表顺序:
dept d(左表) ← LEFT JOIN →emp e(右表) - 连接类型:左连接 → 保 “左表(dept)” 的所有行
- 逻辑:返回
dept的所有部门(哪怕这个部门没有员工),同时匹配emp中该部门的员工数据
1 | select d.name, e.* from employee as e right outer join dept as d on e.dept = d.id; |
- 表顺序:
employee e(左表) ← RIGHT JOIN →dept d(右表) - 连接类型:右连接 → 保 “右表(dept)” 的所有行
- 逻辑:返回
dept的所有部门(哪怕这个部门没有员工),同时匹配emp中该部门的员工数据
(5) 自连接查询
① 当前表与自身的连接查询,自连接必须使用表别名
② 语法:
1 | SELECT 字段列表 FROM 表A 别名A JOIN 表A 别名B ON 条件 ...; |
自连接查询,可以是内连接查询,也可以是外连接查询
③ 代码示例:
1 | -- 查询员工及其所属领导的名字 |
(6) 联合查询 union, union all
① 把多次查询的结果合并,形成一个新的查询集
② 语法:
1 | SELECT 字段列表 FROM 表A ... |
③ 注意事项
- UNION ALL 会有重复结果,UNION 不会
- 联合查询比使用or效率高,不会使索引失效
子查询
(1) SQL语句中嵌套SELECT语句,称谓嵌套查询,又称子查询。
(2) 语法:
1 | SELECT * FROM t1 WHERE column1 = ( SELECT column1 FROM t2); |
子查询外部的语句可以是 INSERT / UPDATE / DELETE / SELECT 的任何一个
③ 根据子查询结果可以分为:
- 标量子查询(子查询结果为单个值)
- 列子查询(子查询结果为一列)
- 行子查询(子查询结果为一行)
- 表子查询(子查询结果为多行多列)
④ 根据子查询位置可分为:
- WHERE 之后
- FROM 之后
- SELECT 之后
(3) 标量子查询
① 子查询返回的结果是单个值(数字、字符串、日期等)。
② 常用操作符:-、<>、>、>=、<、<=
**注意:**在 MySQL 中,<>是 “不等于” 的比较操作符,用于判断两个值是否不相等,等价于!=(二者是完全相同的含义)
③ 代码示例:
1 | select id from dept where name = '销售部'; |
(4) 列子查询
① 返回的结果是一列(可以是多行)。
② 常用操作符:
| 操作符 | 描述 |
|---|---|
| IN | 在指定的集合范围内,多选一 |
| NOT IN | 不在指定的集合范围内 |
| ANY | 子查询返回列表中,有任意一个满足即可 |
| SOME | 与ANY等同,使用SOME的地方都可以使用ANY |
| ALL | 子查询返回列表的所有值都必须满足 |
③ 代码示例:
1 | -- 查询财务部所有人的工资 |
(5) 行子查询
① 返回的结果是一行(可以是多列)。
② 常用操作符:=, <, >, IN, NOT IN
③ 代码示例:
1 | -- 查询与xxx的薪资及直属领导相同的员工信息 |
(6) 表子查询
① 返回的结果是多行多列
② 常用操作符:IN
③ 代码示例:
1 | -- 查询与 “鹿杖客”,“宋远桥” 的职位和薪资相同的员工信息 |
关键逻辑:重点理解外面的「主查询」
遍历emp表的每一个员工,取出他的job和salary组成一个 “组合对”,看这个组合对是否在子查询的 “模板列表” 里(也就是是否是(职员,3750)或(销售,4600)),如果在,就把这个员工的所有信息查出来。
1 | -- 查询入职日期是 “2006-01-01” 之后的员工信息及其部门信息 |
综合练习
(1) 查询年龄小于30岁的员工的姓名、年龄、职位、部门信息(显式内连接)
1 | select e.name, e.age, e.job, d.name from emp e inner join dept d on e.dept_id = d.id where e.age < 30; |
关键逻辑:显式内连接(INNER JOIN)的标准语法结构是:
1 | SELECT 字段 |
① ON是JOIN的 “配套条件”—— 数据库要求,只要写JOIN关联两张表,就必须用ON指定 “两张表怎么关联”,所以ON必须紧跟在JOIN 表2之后;
② WHERE是对 “关联后的结果集” 做筛选,只能放在最后。
(2) 查询拥有员工的部门ID、部门名称
1 | select distinct d.id, d.name from emp e, dept d where e.dept_id = d.id; |
易错点:忘记加 distinct
(3) 查询低于本部门平均工资的员工信息
1 | select * from emp e2 where e2.salary < (select avg(e1.salary) from emp e1 where e1.dept_id = e2.dept_id); |
关键逻辑:
拆分成先算出每个部门的平均工资,再查询低于本部门平均工资的员工信息
1 | select avg(e1.salary) from emp e1 where e1.dept_id = 1; |
事务
事务是一组操作的集合,事务会把所有操作作为一个整体一起向系统提交或撤销操作请求,即这些操作要么同时成功,要么同时失败。
基本操作:
1 | -- 1. 查询张三账户余额 |
操作方式二
(1) 开启事务:
1 | START TRANSACTION 或 BEGIN TRANSACTION; |
(2) 提交事务:
1 | COMMIT; |
(3) 回滚事务:
1 | ROLLBACK; |
(4) 操作实例:
1 | start transaction; |
四大特性ACID
- 原子性(Atomicity):事务是不可分割的最小操作单元,要么全部成功,要么全部失败
- 一致性(Consistency):事务完成时,必须使所有数据都保持一致状态
- 隔离性(Isolation):数据库系统提供的隔离机制,保证事务在不受外部并发操作影响的独立环境下运行
- 持久性(Durability):事务一旦提交或回滚,它对数据库中的数据的改变就是永久的
并发事务
(1) 并发事务问题
| 问题 | 描述 |
|---|---|
| 脏读 | 一个事务读到另一个事务还没提交的数据 |
| 不可重复读 | 一个事务先后读取同一条记录,但两次读取的数据不同 |
| 幻读 | 一个事务按照条件查询数据时,没有对应的数据行,但是再插入数据时,又发现这行数据已经存在 |
(2) 并发事务隔离级别:
| 隔离级别 | 脏读 | 不可重复读 | 幻读 |
|---|---|---|---|
| Read uncommitted(读未提交) | √ | √ | √ |
| Read committed(读已提交) | × | √ | √ |
| Repeatable Read(默认) | × | × | √ |
| Serializable(串行化) | × | × | × |
- √表示在当前隔离级别下该问题会出现
- Serializable 性能最低;Read uncommitted 性能最高,数据安全性最差
① 查看事务隔离级别:
1 | SELECT @@TRANSACTION_ISOLATION; |
② 设置事务隔离级别:
1 | SET [ SESSION | GLOBAL ] TRANSACTION ISOLATION LEVEL {READ UNCOMMITTED | READ COMMITTED | REPEATABLE READ | SERIALIZABLE }; |
SESSION 是会话级别,表示只针对当前会话有效,GLOBAL 表示对所有会话有效
创建数据库的流程
- 点击左侧界面 **“Create data source”,**在弹出的菜单中,选择 “MySQL”
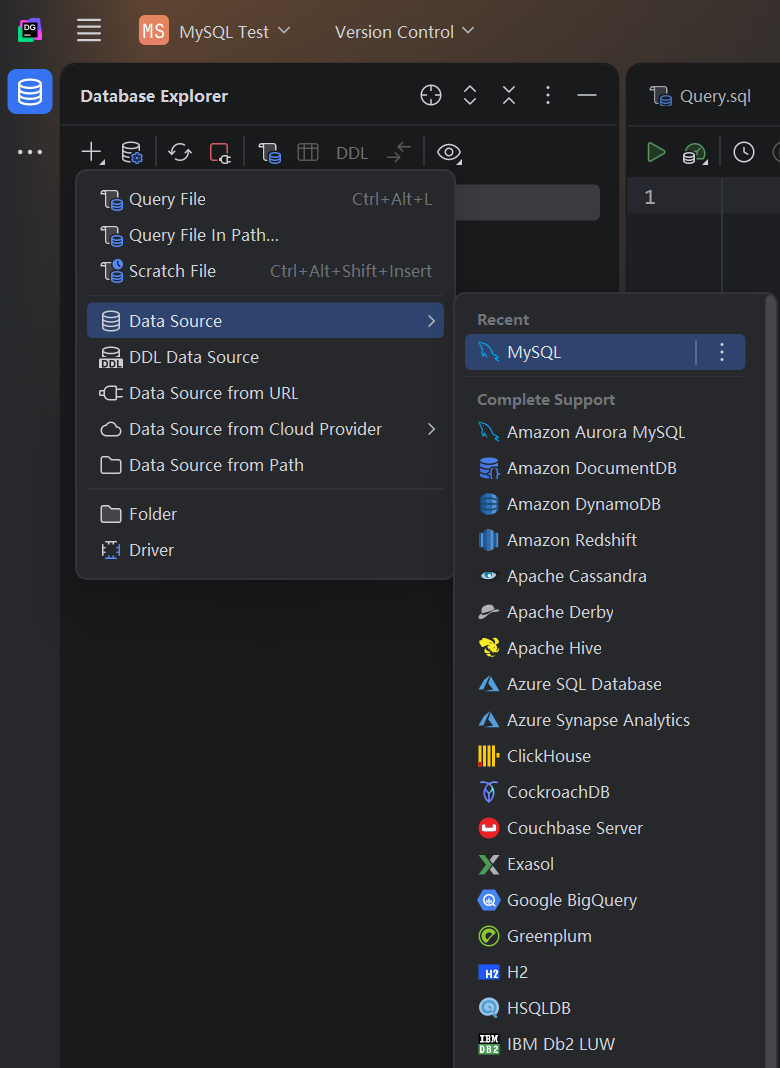
- 填写 MySQL 连接信息,输入User、Password
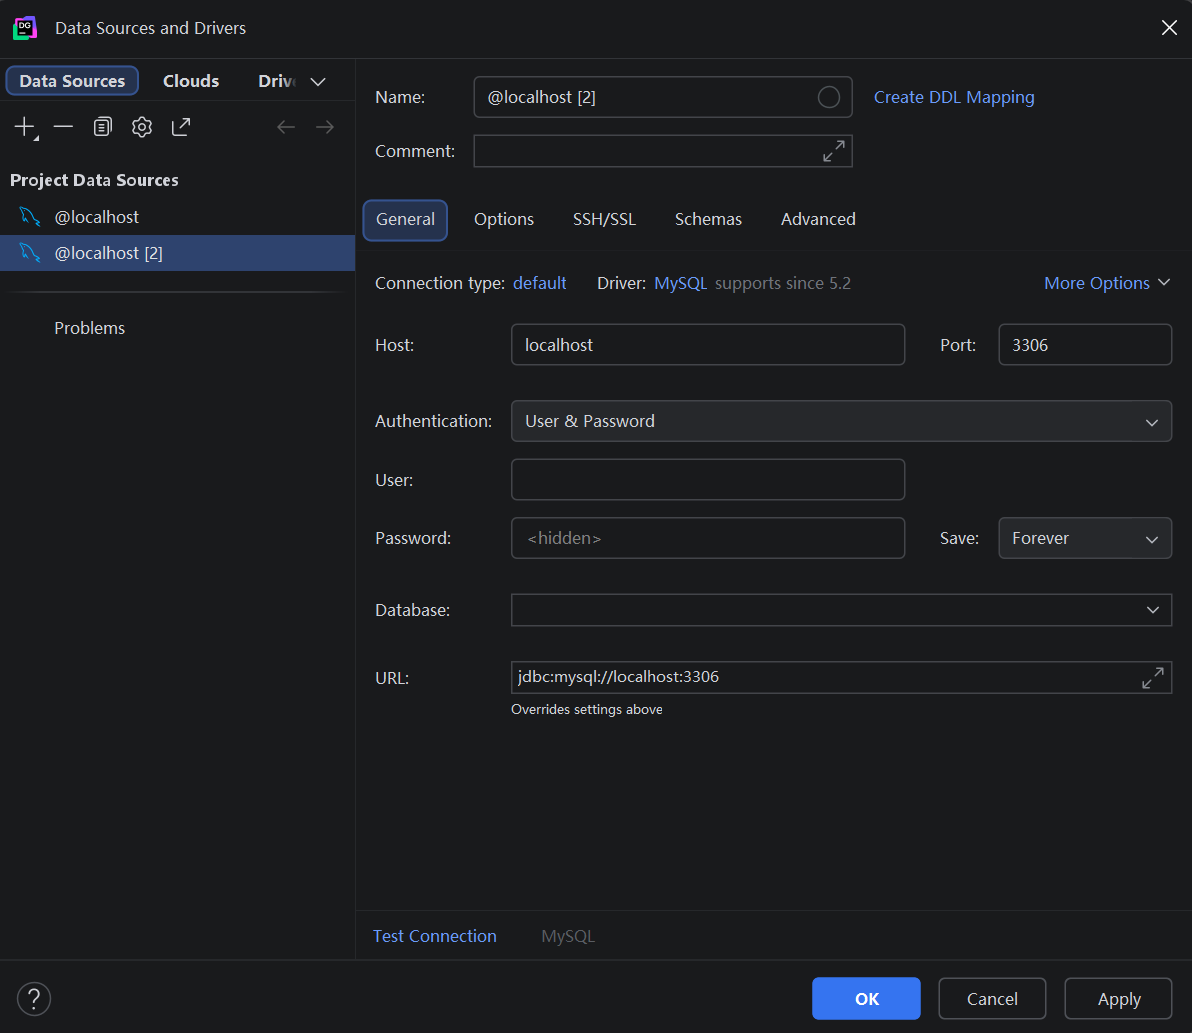
- 下载 MySQL 驱动(首次连接需要),界面会提示 “Download missing driver files”(缺少驱动文件),点击这个提示 → 选择自动下载驱动
- 填写完信息 + 下载驱动后,点击窗口右下角的 **“Test Connection”,**最后点击 “Apply”→“OK”