分布式缓存
Redis持久化
RDB持久化
① 介绍
RDB全称Redis Database Backup file(Redis数据备份文件),也被叫做Redis数据快照。简单来说就是把内存中的所有数据都记录到磁盘中。当Redis实例故障重启后,从磁盘读取快照文件,恢复数据。快照文件称为RDB文件,默认是保存在当前运行目录。
② 执行时机
- save命令
执行下面的命令,可以立即执行一次RDB:
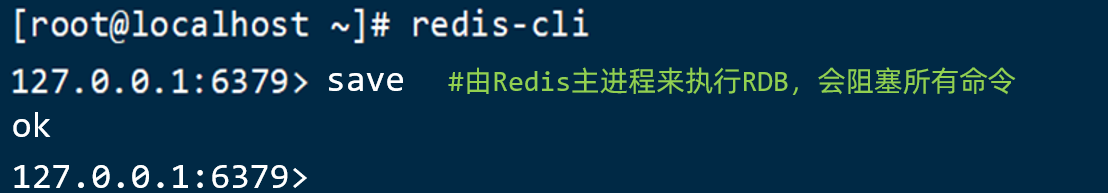
save命令会导致主进程执行RDB,这个过程中其它所有命令都会被阻塞。只有在数据迁移时可能用到。
- bgsave命令
下面的命令可以异步执行RDB:

这个命令执行后会开启独立进程完成RDB,主进程可以持续处理用户请求,不受影响。
- 停机时
Redis停机时会执行一次save命令,实现RDB持久化。
- 触发RDB条件
Redis内部有触发RDB的机制,可以在redis.conf文件中找到,格式如下:
1 | # 900秒内,如果至少有1个key被修改,则执行bgsave , 如果是save "" 则表示禁用RDB |
RDB的其它配置也可以在redis.conf文件中设置:
1 | # 是否压缩 ,建议不开启,压缩也会消耗cpu,磁盘的话不值钱 |
③ RDB原理
- bgsave开始时会fork主进程得到子进程,子进程共享主进程的内存数据。完成fork后读取内存数据并写入 RDB 文件。
- fork采用的是copy-on-write技术:
- 当主进程执行读操作时,访问共享内存;
- 当主进程执行写操作时,则会拷贝一份数据,执行写操作。
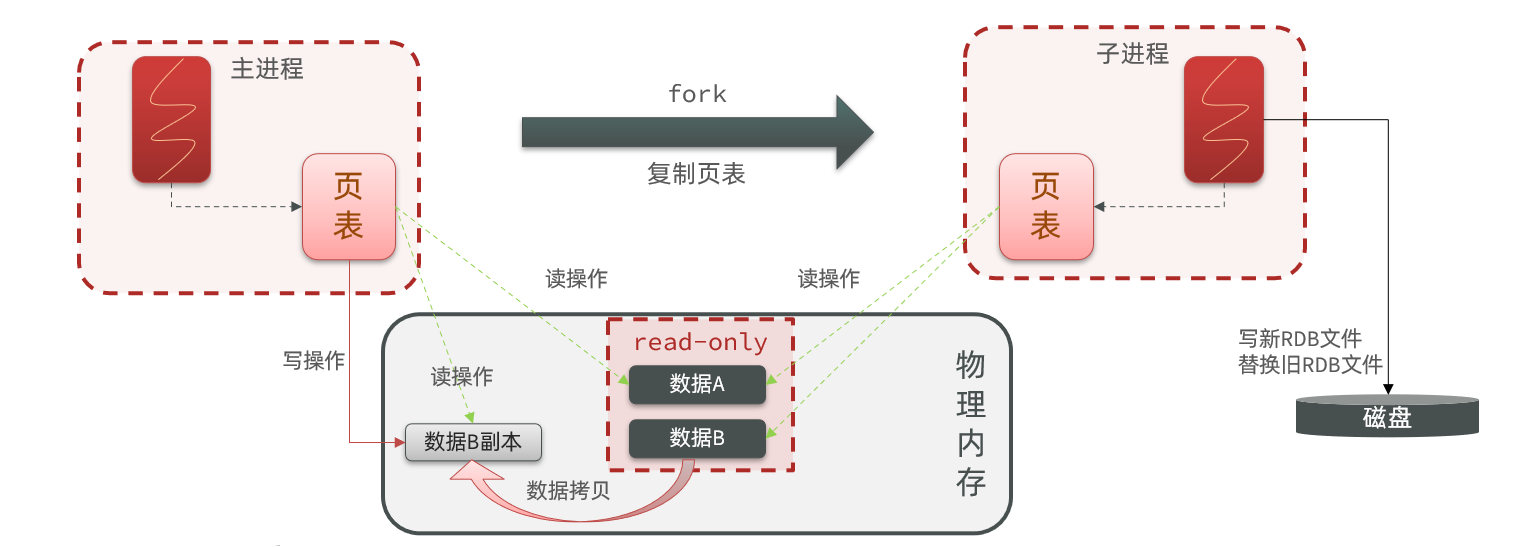
- 当主进程要修改某块数据(比如图里的「数据 B」)时:
- 操作系统发现这块数据是只读的,先在物理内存里拷贝一份新副本(「数据 B 副本」)
- 主进程更新页表,让自己指向这个新副本,然后在副本上执行写操作
- 原来的「数据 B」保持不变,继续给子进程读(保证子进程看到的是
fork那一刻的完整数据,不会被主进程的修改打乱)
AOF持久化
① 介绍
AOF全称为Append Only File(追加文件)。Redis处理的每一个写命令都会记录在AOF文件,可以看做是命令日志文件。
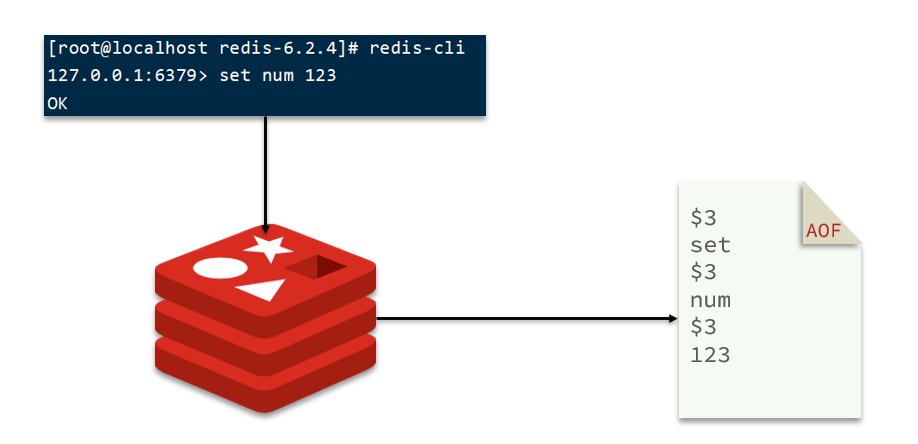
② AOF配置
- AOF默认是关闭的,需要修改redis.conf配置文件来开启AOF:
1 | # 是否开启AOF功能,默认是no |
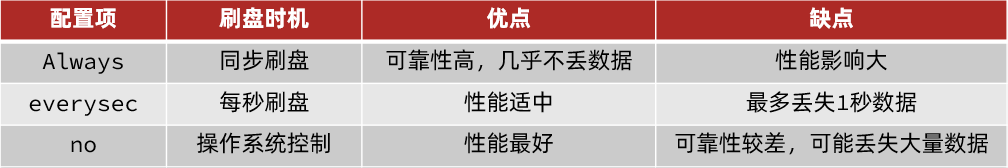
- AOF的命令记录的频率也可以通过redis.conf文件来配:
1 | # 表示每执行一次写命令,立即记录到AOF文件 |
AOF文件重写
因为是记录命令,AOF文件会比RDB文件大的多。而且AOF会记录对同一个key的多次写操作,但只有最后一次写操作才有意义。通过执行bgrewriteaof命令,可以让AOF文件执行重写功能,用最少的命令达到相同效果。
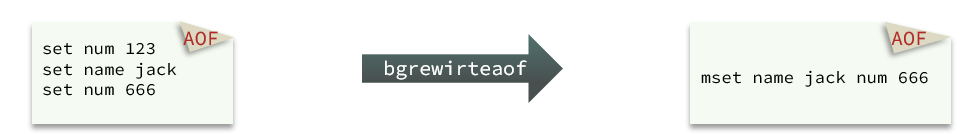
如图,AOF原本有三个命令,但是set num 123 和 set num 666都是对num的操作,第二次会覆盖第一次的值,因此第一个命令记录下来没有意义。 所以重写命令后,AOF文件内容就是:mset name jack num 666
Redis主从
主从数据同步原理
① 全量同步
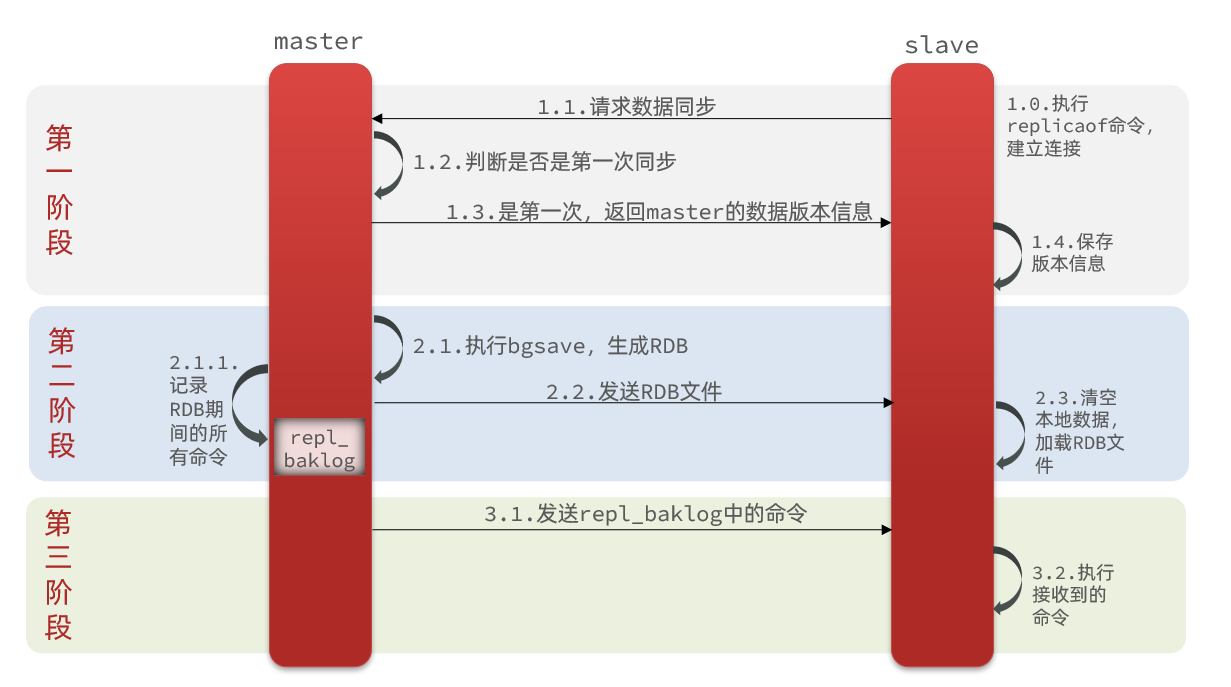
主从第一次建立连接时,会执行全量同步,将master节点的所有数据都拷贝给slave节点,流程如下:
- 核心概念
Replication ID(replid)
- 每个 master 都有一个唯一的 replid,它是当前数据集的 “身份证”,代表这一套完整数据。
- slave 会继承 master 的 replid,所以同一套数据集的 master 和 slave,replid 一定是一致的。
offset(偏移量)
- master 每执行一条写命令,offset 就会递增,同时把命令记录到
repl_backlog缓冲区。 - slave 同步完成后,也会记录自己当前同步到的 offset。
- 如果 slave 的 offset < master 的 offset,说明 slave 数据落后,需要补同步。
- master 如何判断 slave 是「第一次连接」?
判断逻辑非常简单:看 replid 是否一致
当它第一次执行 replicaof 变成 slave,连接 master 时,会把自己原来的 replid 和 offset 发给 master。
master 检查:
- 如果 slave 的 replid ≠ 自己的 replid → 判定这是全新的 slave(第一次连接),需要做全量同步。
- 如果 slave 的 replid = 自己的 replid → 判定这是重连的 slave,只需要做增量同步(补 offset 之后的命令)。
- 完整主从同步流程
第一步:连接协商(psync 阶段)
- slave 执行
replicaof,和 master 建立连接,发送psync <slave的replid> <slave的offset>。 - master 发现 slave 的 replid 和自己不一致 → 拒绝增量同步,返回自己的 replid 和当前 offset。
- slave 保存 master 的 replid 和 offset,之后它的 replid 就和 master 一致了。
第二步:全量同步(RDB 阶段)
- master 后台执行
bgsave,生成 RDB 快照(把当前内存里的所有数据导出成文件)。 - 生成 RDB 的同时,master 会把这段时间收到的所有写命令,记录到
repl_backlog缓冲区(避免这段时间的数据丢失)。 - RDB 生成后,master 把文件发送给 slave。
- slave 清空本地所有数据,加载 RDB 文件,恢复到 master 生成 RDB 时的状态。
第三步:增量同步(命令回放阶段)
- master 把
repl_backlog里记录的、RDB 生成期间的所有写命令,逐条发给 slave。 - slave 接收并执行这些命令,把 RDB 之后的操作全部补上,最终和 master 数据完全一致。
- 之后,master 每收到一条写命令,都会实时同步给所有 slave,slave 执行命令,保持持续同步。
② repl_backlog原理
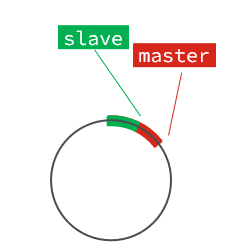
repl_backlog是 master 节点上的一个固定大小的环形数组缓冲区:
- 环形结构:数组下标走到末尾后,会从 0 重新开始读写,旧数据会被新数据覆盖。
- 存储内容:保存 master 最近处理过的写命令日志,以及每条命令对应的
offset(偏移量)。 - 核心作用:通过对比 master 和 slave 的
offset,精准定位两者的数据差异,实现高效增量同步。
2) 正常同步流程
offset 标记差异
master 维护自己的当前 offset(红色标记),slave 维护自己已同步到的 offset(绿色标记)。两者之间的差值,就是 slave 缺失的、需要增量同步的命令数据。
同步追赶
随着 master 不断写入新数据,它的 offset 持续增大;slave 不断从 master 拉取命令并执行,自己的 offset 也在追赶 master 的 offset,绿色(已同步)区域逐渐扩大。
安全覆盖
当缓冲区被写满后,新写入的命令会覆盖最旧的数据:
- 被覆盖的如果是 绿色(已同步到 slave)的数据,完全没有影响,因为这些数据已经不需要再同步了;
- 未同步的只有 红色(master 与 slave 之间)的部分,只要这部分还在缓冲区里,就能继续增量同步。
3) 异常场景:网络阻塞
当 slave 出现网络阻塞、长时间无法同步时,流程会发生变化:
差距拉大
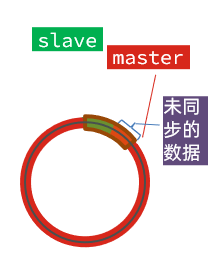
master 持续写入,offset 快速增长,而 slave 的 offset 停滞不前,两者的差距(红色未同步区域)越来越大。
缓冲区覆盖危机
棕色框中的红色部分,就是尚未同步,但是却已经被覆盖的数据。此时如果slave恢复,需要同步,却发现自己的offset都没有了,无法完成增量同步了。只能做全量同步。
主从同步优化
可以从以下几个方面来优化Redis主从就集群:
- 在master中配置repl-diskless-sync yes启用无磁盘复制,避免全量同步时的磁盘IO。
- Redis单节点上的内存占用不要太大,减少RDB导致的过多磁盘IO
- 适当提高repl_baklog的大小,发现slave宕机时尽快实现故障恢复,尽可能避免全量同步
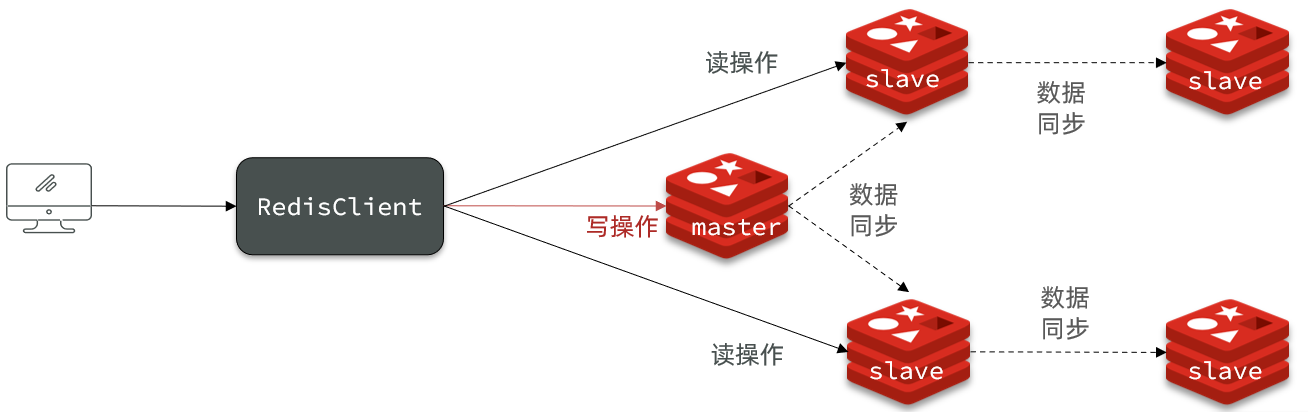
- 限制一个master上的slave节点数量,如果实在是太多slave,则可以采用主-从-从链式结构,减少master压力
Redis哨兵
哨兵原理
① 集群结构和作用
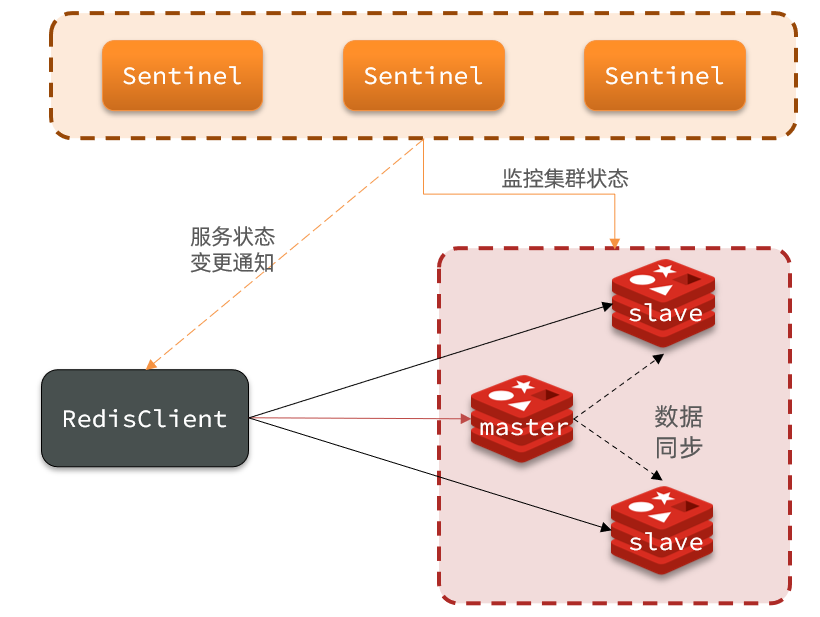
哨兵的作用如下:
- 监控:Sentinel 会不断检查您的master和slave是否按预期工作
- 自动故障恢复:如果master故障,Sentinel会将一个slave提升为master。当故障实例恢复后也以新的master为主
- 通知:Sentinel充当Redis客户端的服务发现来源,当集群发生故障转移时,会将最新信息推送给Redis的客户端
② 集群监控原理
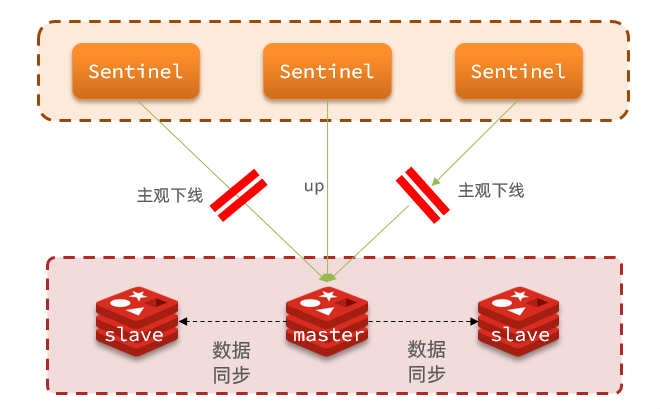
Sentinel基于心跳机制监测服务状态,每隔1秒向集群的每个实例发送ping命令:
- 主观下线:如果某sentinel节点发现某实例未在规定时间响应,则认为该实例主观下线。
- 客观下线:若超过指定数量(quorum)的sentinel都认为该实例主观下线,则该实例客观下线。quorum值最好超过Sentinel实例数量的一半。
③ 集群故障恢复原理
一旦发现master故障,sentinel需要在salve中选择一个作为新的master,选择依据是这样的:
- 首先会判断slave节点与master节点断开时间长短,如果超过指定值(down-after-milliseconds * 10)则会排除该slave节点
- 然后判断slave节点的slave-priority值,越小优先级越高,如果是0则永不参与选举
- 如果slave-prority一样,则判断slave节点的offset值,越大说明数据越新,优先级越高
- 最后是判断slave节点的运行id大小,越小优先级越高。
④ 如何实现故障转移
- sentinel给备选的slave1节点发送slaveof no one命令,让该节点成为master
- sentinel给所有其它slave发送slaveof 192.168.150.101 7002 命令,让这些slave成为新master的从节点,开始从新的master上同步数据。
- 最后,sentinel将故障节点标记为slave,当故障节点恢复后会自动成为新的master的slave节点
RedisTemplate
① 配置Redis地址
1 | spring: |
② 配置读写分离
1 |
|
这个bean中配置的就是读写策略,包括四种:
- MASTER:从主节点读取
- MASTER_PREFERRED:优先从master节点读取,master不可用才读取replica
- REPLICA:从slave(replica)节点读取
- REPLICA _PREFERRED:优先从slave(replica)节点读取,所有的slave都不可用才读取master
Redis分片集群
散列插槽
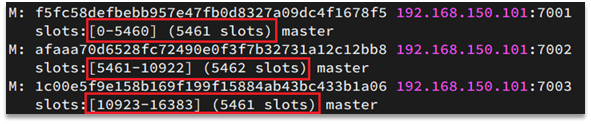
① 插槽的 “分配规则”:16384 个插槽分给所有 master 节点
Redis 集群总共有 0~16383 这 16384 个插槽(相当于 16384 个 “数据格子”),这些插槽会平均分给集群里的所有 master 节点。
② 数据的 “寻址规则”:key→插槽号→节点
Redis 存数据时,会先给 key 算一个插槽号,再找这个插槽号对应的节点,步骤如下:
步骤 1:确定 key 的 “有效部分”(计算的依据)
- 情况 1:key 里没有
{}→ 整个 key 都是有效部分(比如num、a,就用完整的num/a计算); - 情况 2:key 里有
{}→ 只算{}里的内容(比如{itcast}num,只算itcast,不管外面的num);
步骤 2:计算插槽号(固定算法)
用「有效部分」通过 CRC16 算法 算出一个数字,再对 16384 取余数(余数范围 0~16383),结果就是插槽号。
集群伸缩
① 需求分析
需求:向集群中添加一个新的master节点,并向其中存储 num = 10
- 启动一个新的redis实例,端口为7004
- 添加7004到之前的集群,并作为一个master节点
- 给7004节点分配插槽,使得num这个key可以存储到7004实例
② 创建新的redis实例
做什么:创建 7004 的工作目录、修改配置、启动实例
1 | # 1. 创建7004目录 |
③ 添加新节点到redis
做什么:用add-node把 7004 接入集群,此时 7004 是 master,但0 个哈希槽,存不了数据
1 | # 语法:redis-cli --cluster add-node 新节点IP:端口 集群任意已有节点IP:端口 |
④ 添加新节点到redis
做什么:算出num这个 key 对应的槽位,确认它在哪个旧主节点的槽区间里
1 | # 计算num的哈希槽号 |
✅ 结果:num对应槽位2765,属于 7001 的0-5460槽区间,因此要从 7001 移槽。
⑤ 转移插槽
做什么:交互式把0-3000的槽(包含 2765)从 7001 迁移到 7004,数据会跟着槽自动迁移
1 | # 启动reshard,指定集群任意节点 |
故障转移
① 自动故障转移
1 | # 1. 直接杀掉7002进程(模拟宕机) |
✅ 结果:过几秒后,7002 的从节点(比如 8002)会自动变成 Master。
② 手动故障转移
- 利用cluster failover命令可以手动让集群中的某个master宕机,切换到执行cluster failover命令的这个slave节点,实现无感知的数据迁移。其流程如下:
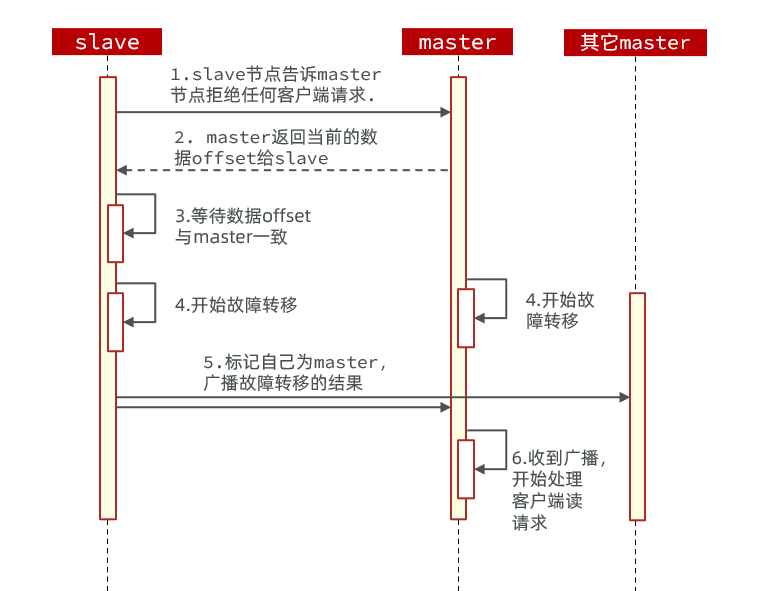
- 这种failover命令可以指定三种模式:
- 缺省:默认的流程,如图1~6歩
- force:省略了对offset的一致性校验
- takeover:直接执行第5歩,忽略数据一致性、忽略master状态和其它master的意见
- 实操步骤
连接到 7002 的从节点(比如 8002)
1 | redis-cli -p 8002 |
执行故障转移命令
1 | 127.0.0.1:8002> CLUSTER FAILOVER |